OpenSpec beschreibt sehr genau, was ein System tun soll. Wie ein Benutzer Schritt für Schritt durch die Anwendung geht, steht aber nirgends am Stück. Das ist kein Fehler im Tool, sondern eine bewusste Entscheidung des Formats, und sie hat Folgen.
Ich habe die Spring PetClinic auf OpenSpec umgestellt. Daraus entstanden fünf Capabilities mit 31 Requirements und 52 Scenarios. Danach kam die naheliegende Frage: Wo sehe ich eigentlich den Ablauf aus Sicht des Benutzers? In diesem Beitrag beantworte ich sie und vergleiche OpenSpec mit dem AI Unified Process. Der AI Unified Process stellt genau diese Benutzersicht ins Zentrum.
Wie OpenSpec Verhalten beschreibt
OpenSpec gliedert ein System in Capabilities. Jede Capability ist eine Datei openspec/specs/<capability>/spec.md und hat drei Ebenen:
- Purpose: zwei, drei Sätze, wofür die Capability da ist.
- Requirements: einzelne Regeln, formuliert als „The system SHALL …“.
- Scenarios: konkrete Fälle pro Requirement im Format WHEN/THEN. Sie dienen als Akzeptanzkriterien und als Vorlage für Tests.
So sieht das in der PetClinic aus:
### Requirement: Find owners by last name

The system SHALL let staff search owners by the beginning of their last name.

#### Scenario: Exactly one owner matches

- **WHEN** staff search for "Fra" and exactly one owner's last name starts with "Fra"
- **THEN** staff are redirected straight to that owner's details page
Neue Features entstehen als Change in openspec/changes/<name>/. Ein Change besteht aus einem proposal.md (Warum und Was), optional einem design.md, einer tasks.md und Delta-Specs. Die Delta-Specs sagen, welche Requirements hinzukommen, sich ändern oder wegfallen. Beim Archivieren werden die Deltas in die Haupt-Specs übernommen. Die Specs zeigen also immer den aktuellen Stand des Systems.
Warum der Ablauf fehlt
OpenSpec beschreibt Regeln, nicht Abläufe. Ein Scenario zeigt genau eine Interaktion: eine Aktion des Benutzers und die Reaktion des Systems. Die Reihenfolge der Schritte, den Kontext davor und danach und den Weg durch mehrere Masken beschreibt es nicht.
Dazu kommt, dass ein Ablauf quer über die Capabilities läuft. Wer in der PetClinic einen Besuch storniert, berührt vier Spec-Dateien:
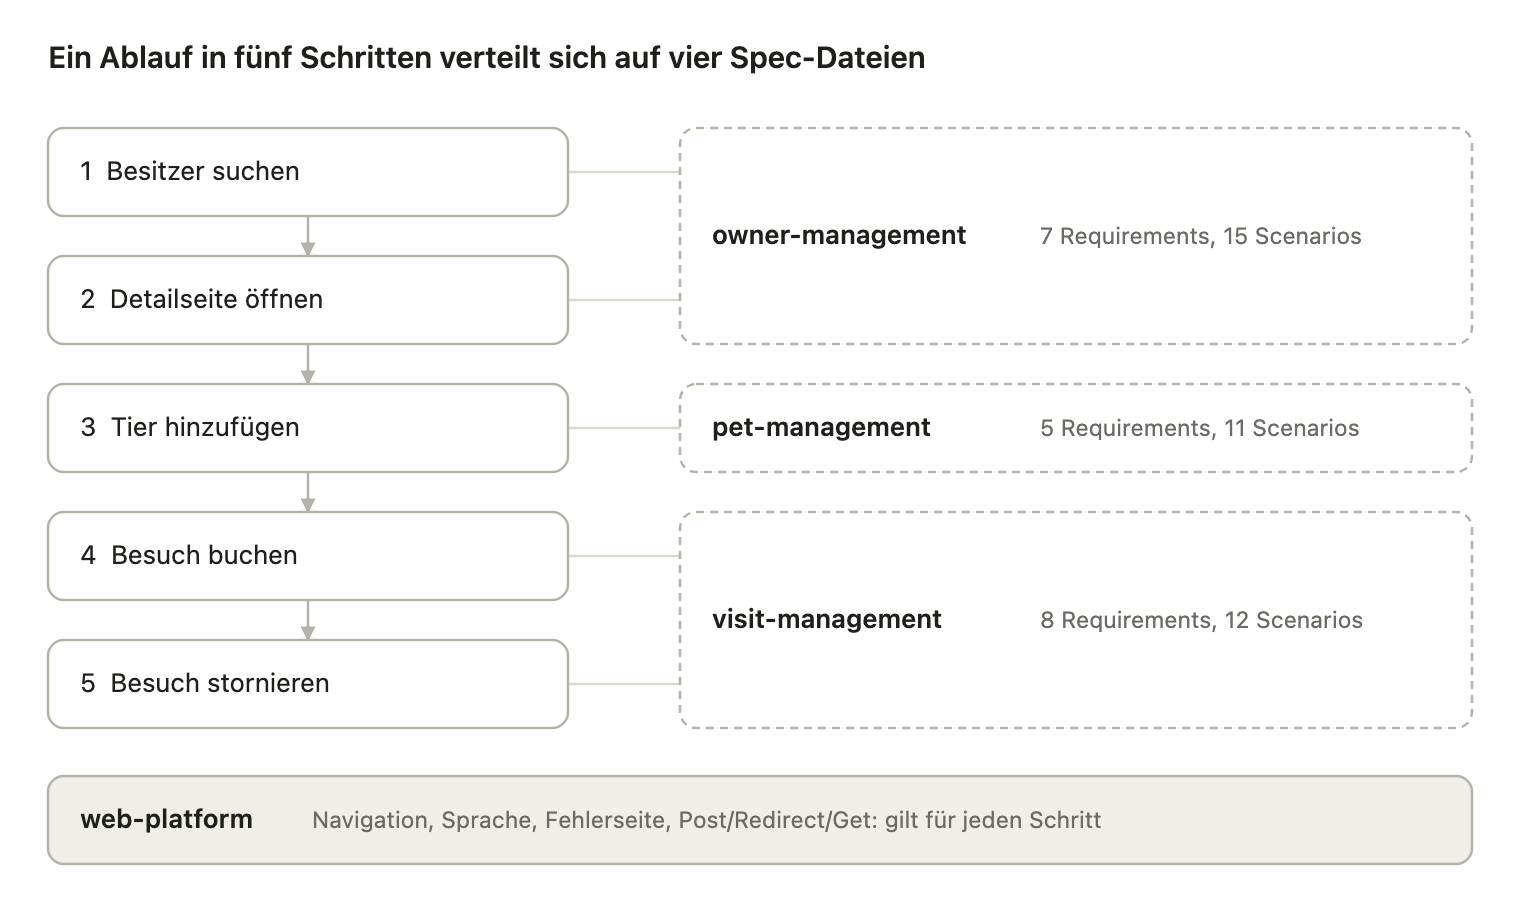
Die Reihenfolge entsteht erst im Kopf des Lesers oder in der Navigation der UI. Den Weg von der Suche bis zur Stornierung findet man in keiner Datei. Auch alternative Wege sind verstreut: „Kein Besitzer gefunden“ ist ein Scenario in owner-management, „Vergangener Besuch kann nicht storniert werden“ ein eigenes Requirement in visit-management.
Das Format ist auf Deltas ausgelegt. Regeln lassen sich pro Change sauber hinzufügen, ändern oder entfernen. Ein Ablauf über vier Dateien passt nicht in dieses Schema. Der Preis dafür: Wer die Specs prüft, sieht einzelne Regeln, aber nicht, ob der Ablauf als Ganzes vollständig ist.
Wie man die Lücke schliesst
Wer die Benutzersicht in OpenSpec braucht, hat drei Wege. Sie unterscheiden sich darin, wie viel zusätzliche Pflege sie kosten.
- User Journey im Purpose: In jede Spec ein kurzer nummerierter Ablauf direkt unter dem Purpose. OpenSpec parst nur Requirements und Scenarios, der Text stört also nicht. Der Nachteil: Der Ablauf endet an der Grenze der Capability.
- Eine eigene
openspec/journeys.md: Die wichtigsten End-to-End-Abläufe als nummerierte Liste oder Mermaid-Diagramm, jeder Schritt mit Link auf das Requirement. Das deckt den Ablauf über Capabilities hinweg ab. Die Datei ist aber nicht Teil des Change-Workflows, und niemand prüft, ob sie nach einem Archive noch stimmt. - Use Cases daneben: Klassische Use-Case-Spezifikationen mit Hauptszenario und alternativen Abläufen. Das ist am nächsten an der Benutzersicht, bedeutet aber ein zweites Spec-Format, das parallel gepflegt werden muss.
Der dritte Weg führt direkt zur Frage, ob man dann nicht gleich mit Use Cases arbeitet. Genau das macht der AI Unified Process.
Der AI Unified Process im Vergleich
Der AI Unified Process beginnt beim Benutzer und arbeitet sich zum Code vor. Seine Artefakte liegen in docs/, haben IDs und verweisen aufeinander:
- Requirements-Katalog: funktionale Anforderungen als User Stories (FR-XXX), messbare nicht-funktionale Anforderungen, Constraints und ein Glossar.
- Use-Case-Diagramm: PlantUML mit Akteuren und Use Cases als Übersicht.
- Use-Case-Spezifikation pro Use Case (UC-XXX): Akteure, Vorbedingungen, Hauptszenario Schritt für Schritt, alternative Abläufe, Nachbedingungen, Geschäftsregeln. Das ist der Ablauf aus Benutzersicht, den OpenSpec nicht hat.
- Entity Model: Mermaid-ER-Diagramm mit Attributen, Datentypen und Validierungsregeln.
- Geschäftsprozesse (BP-XXX): BPMN mit einer Lane pro Akteur. Jede Aktivität ist ein Use Case. Das zeigt Abläufe über Rollen und Use Cases hinweg.
- Testfälle (TC-XXX): End-to-End-Journeys, die mehrere Use Cases mit konkreten Testdaten verketten. Sie werden aus Prozessen abgeleitet und als Browser-Tests automatisiert.
Dazu kommen Werkzeuge, die die Kette prüfen. Ein Spec-Review lintet die Artefakte gegeneinander und erzeugt eine Traceability-Matrix. Ein Coverage-Check zeigt pro Use Case, welche Schritte, alternativen Abläufe und Regeln Code und Tests haben. Für die Umsetzung gibt es Skills für einen konkreten Stack, zum Beispiel Vaadin mit jOOQ.
Für die PetClinic hiesse das: „Besuch stornieren“ wäre ein Use Case mit Hauptszenario (Besitzer finden, Tier wählen, Besuch stornieren, Bestätigung) und alternativem Ablauf „Besuch liegt in der Vergangenheit“. Der ganze Weg von der Suche bis zur Stornierung wäre ein Testfall.
Bestehende Anwendungen: ohne Ablauf keine Validierung
Bei bestehenden Anwendungen wird der Unterschied am deutlichsten. Bevor Deltas Sinn ergeben, braucht es eine Baseline, also Specs für das, was die Anwendung heute tut. OpenSpec bringt dafür keinen Skill mit. Die Workflows propose, apply, sync und archive gehen davon aus, dass die Baseline schon da ist.
In der PetClinic hat ein Agent die fünf Specs ad hoc aus Controllern, Entities und Templates abgeleitet. Im Purpose steht entsprechend „Reverse-engineered from OwnerController …“. Ob das Ergebnis stimmt, muss jemand prüfen, der die Anwendung fachlich kennt. Diese Person bekommt 31 Regeln und 52 Scenarios. Sie kann jede Regel einzeln bestätigen. Ob ein Schritt, eine Maske oder ein Sonderfall fehlt, sieht sie nicht, weil nichts die Regeln zu einem Ablauf verbindet. Lücken zwischen den Requirements bleiben unsichtbar.
Der AI Unified Process hat dafür einen eigenen Schritt. /reverse-engineer erzeugt aus dem bestehenden Code ein Use-Case-Diagramm, Use-Case-Spezifikationen und ein Entity Model. Der Fachbereich geht das Hauptszenario so durch, wie er mit der Anwendung arbeitet: Besitzer suchen, Tier wählen, Besuch stornieren. Fehlt ein Schritt oder ein alternativer Ablauf, fällt das beim Lesen auf. Das Spec-Review prüft zusätzlich, ob die Artefakte zueinander passen. Wie das im Detail funktioniert, beschreibe ich in Reverse Engineering: Specs aus bestehendem Code.
Damit sind auch reverse-engineerte Use Cases nicht automatisch richtig. Sie beschreiben, was der Code tut, inklusive seiner Fehler. Aber sie haben eine Form, die ein Mensch gegen sein Wissen über die Anwendung prüfen kann. Bei einer Liste von Regeln fehlt genau das.
Vor- und Nachteile
Der AI Unified Process liefert, was OpenSpec fehlt: den Ablauf aus Benutzersicht, einen Weg von bestehendem Code zu prüfbaren Specs, ein Datenmodell und Nachvollziehbarkeit bis zum Test. OpenSpec ist dafür leichter im Einstieg und verfolgt einzelne Änderungen sauberer.
| Kriterium | OpenSpec | AI Unified Process |
|---|---|---|
| Ablauf aus Benutzersicht | Nur einzelne Scenarios, verteilt auf Capabilities | Hauptszenario und alternative Abläufe pro Use Case, Prozesse über Use Cases hinweg |
| Bestehende Anwendungen | Kein Reverse Engineering, die Baseline entsteht ad hoc und ist ohne Ablauf schwer zu validieren | /reverse-engineer erzeugt Use Cases und Entity Model aus dem Code, der Fachbereich validiert am Ablauf |
| Validierung durch den Fachbereich | Regeln einzeln prüfbar, Lücken zwischen Regeln unsichtbar | Vertrautes Use-Case-Format, fehlende Schritte fallen beim Durchgehen auf |
| Datenmodell | Kein eigenes Artefakt, steckt in Requirements und Code | Entity Model mit ER-Diagramm und Validierungsregeln |
| Nachvollziehbarkeit | Requirement → Scenario → Test, keine IDs über Dateien hinweg | IDs von FR über UC und BP bis TC, Traceability-Matrix und Coverage-Check |
| Testableitung | Ein Scenario wird zu einem Unit- oder Web-Test | Use Cases werden zu View-Tests, Testfälle zu End-to-End-Tests |
| Einzelne Änderungen verfolgen | Stärke: Delta-Specs mit ADDED, MODIFIED und REMOVED, Archiv als Historie | Änderungen gehen direkt in die Use Cases, Historie über Git |
| Einstieg | Schnell: /opsx:propose erzeugt Proposal, Design, Tasks und Delta-Specs in einem Schritt |
Mehr Vorarbeit: Requirements, Diagramm, Use Cases und Entity Model vor dem ersten Code |
| Pflegeaufwand | Gering, eine Datei pro Capability | Höher, mehrere Artefakte müssen konsistent bleiben, das Spec-Review hilft dabei |
| Stack | Unabhängig, Projektregeln in openspec/config.yaml |
Methode unabhängig, Umsetzungs-Skills für konkrete Stacks wie Vaadin mit jOOQ |
Zwei Punkte fallen in der Praxis besonders auf. Bei OpenSpec ist der Change-Workflow so reibungslos, dass man schnell vergisst, wie wenig vom Gesamtablauf festgehalten ist. Beim AI Unified Process ist es umgekehrt: Das Gesamtbild ist da, aber jede kleine Änderung berührt mehrere Dokumente, und ohne Spec-Review laufen sie auseinander.
Fazit
OpenSpec beantwortet die Frage „Was gilt?“, der AI Unified Process die Frage „Was tut der Benutzer?“. Welche Frage wichtiger ist, hängt vom Projekt ab:
- AI Unified Process: bestehende Anwendungen, deren Verhalten erst erfasst und vom Fachbereich bestätigt werden muss. Ebenso neue Anwendungen, Abläufe über mehrere Rollen und überall, wo eine Anforderung bis zum Test nachvollziehbar sein muss.
- OpenSpec: kleine, klar abgegrenzte Features in einem Projekt, dessen Abläufe das Team bereits kennt und nicht mit dem Fachbereich abstimmen muss.
Der Ablauf aus Benutzersicht ist keine Dokumentation für später. Er ist das, woran Fachleute prüfen, ob die Spec stimmt. Wer bei OpenSpec bleibt, kann eine journeys.md mit Links auf die Requirements ergänzen und bei jedem Archive mitpflegen. Der AI Unified Process macht diesen Ablauf von Anfang an zum zentralen Artefakt.